L’intelligenza artificiale potrebbe diventare uno strumento di supporto anche nella formazione clinica degli odontoiatri, ma la strada verso una valutazione automatizzata affidabile non è ancora priva di criticità.
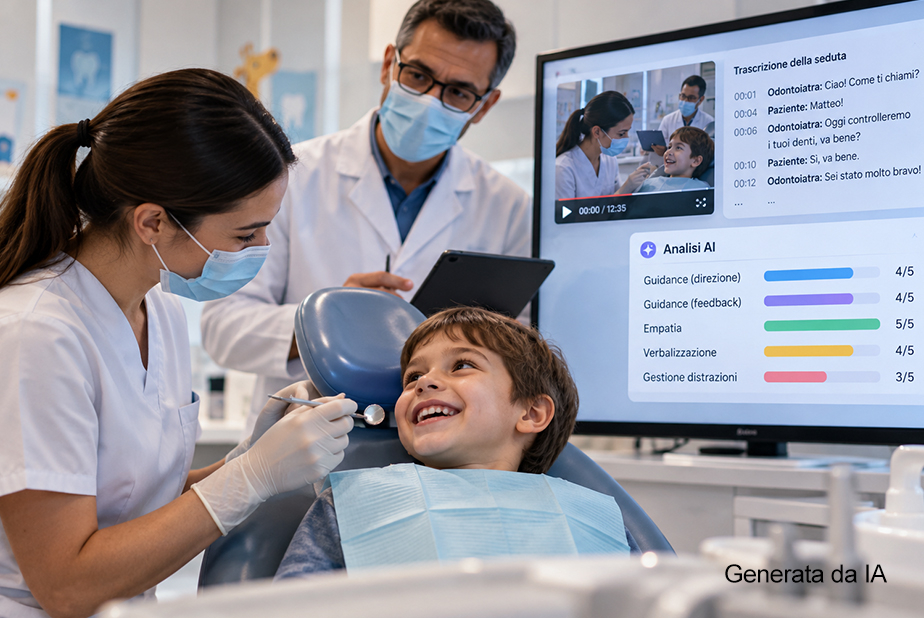
È quanto emerge da uno studio che ha analizzato la possibilità di utilizzare trascrizioni testuali e large language model per valutare la gestione comportamentale dei pazienti pediatrici da parte degli studenti di odontoiatria.
La ricerca parte da un problema concreto della formazione clinica: il feedback personalizzato può migliorare le capacità degli studenti nella gestione del comportamento del paziente pediatrico, ma richiede molto tempo da parte dei docenti. La revisione delle registrazioni video consente una valutazione dettagliata dell’intera seduta, ma una singola sessione può durare fino a 90 minuti.
Dalle registrazioni video alle trascrizioni
Lo studio ha preso in esame 40 incontri clinici videoregistrati che coinvolgevano studenti dell’ultimo anno impegnati nel trattamento di pazienti di età compresa tra 4 e 12 anni.
Le sessioni erano state precedentemente valutate attraverso una scala validata per la gestione comportamentale in odontoiatria pediatrica. Gli incontri sono stati successivamente trascritti integralmente e nuovamente valutati attraverso una versione modificata della stessa scala, dalla quale erano stati eliminati gli elementi non verbali non rilevabili attraverso il solo testo.
La differenza in termini di tempo è risultata significativa. La durata media dei video era di 73 minuti, con un intervallo compreso tra 37 e 120 minuti, mentre la valutazione delle trascrizioni richiedeva in media 12 minuti, con tempi compresi tra 3 e 25 minuti.
Nonostante la riduzione dei tempi, il confronto tra valutazioni basate sulle trascrizioni e quelle ottenute dai video ha mostrato un buon livello di affidabilità. Il coefficiente di correlazione intraclasse è risultato pari a 0,830, mentre il confronto con i video privati delle componenti non verbali ha raggiunto un accordo assoluto di 0,834.
Secondo gli autori, questi dati suggeriscono che le trascrizioni testuali possano rappresentare uno strumento utile per ridurre il carico di lavoro dei docenti mantenendo una buona corrispondenza con la valutazione effettuata attraverso il video completo.
Il test con ChatGPT
I ricercatori hanno quindi valutato se la stessa attività potesse essere automatizzata attraverso modelli linguistici.
Sono state utilizzate due versioni di ChatGPT: una versione gratuita basata su GPT-4o e una versione a pagamento basata su o4-mini-high. Entrambe hanno ricevuto le stesse trascrizioni, la scala di valutazione e informazioni di riferimento sulla gestione comportamentale pediatrica.
Ogni incontro clinico è stato sottoposto al modello tre volte, sempre utilizzando lo stesso prompt, per verificare non soltanto l’accordo con la valutazione umana ma anche la stabilità dei risultati.
Il confronto con il valutatore umano ha mostrato un accordo moderato per entrambi i modelli. Il coefficiente di accordo assoluto è risultato pari a 0,729 per la versione gratuita e a 0,670 per quella a pagamento.
Il problema principale è emerso però sul piano della coerenza.
Con lo stesso prompt e la stessa trascrizione, la versione gratuita ha restituito lo stesso punteggio in tutte e tre le prove soltanto in 7 casi su 40, pari al 18%, mentre la versione a pagamento ha fornito risultati identici soltanto in 4 casi su 40, pari al 10%.
La variabilità media dei punteggi è stata inoltre inferiore nella versione gratuita rispetto a quella a pagamento: rispettivamente 1,73 punti contro 2,85 punti, con una differenza statisticamente significativa.
Il limite delle interazioni ridotte al solo testo
Uno dei punti critici individuati dagli autori riguarda la natura stessa dell’input utilizzato dai modelli linguistici.
Le trascrizioni non permettono infatti di considerare aspetti essenziali della comunicazione clinica come tono della voce, gestualità, postura, espressioni facciali e altri segnali non verbali. Per questo motivo la valutazione basata esclusivamente sul testo non può restituire integralmente la complessità dell’interazione tra studente e paziente.
Nel caso specifico, la scala di valutazione utilizzata per le trascrizioni è stata quindi adattata eliminando proprio le componenti non verbali.
Gli autori evidenziano inoltre che le trascrizioni provenivano da situazioni cliniche reali, caratterizzate anche dalla presenza di linguaggio informale, slang e colloquialismi. Questa variabilità potrebbe avere contribuito all’instabilità dei punteggi prodotti dai modelli.
Uno strumento promettente, ma non ancora sostitutivo
Nel complesso, lo studio suggerisce che le trascrizioni possano rappresentare un modo efficace per rendere più sostenibile la valutazione delle performance cliniche degli studenti, riducendo sensibilmente il tempo necessario rispetto alla revisione integrale dei video.
L’impiego dei large language model potrebbe consentire un’ulteriore automazione del processo e facilitare la produzione di feedback personalizzati su un numero maggiore di studenti. Tuttavia, la variabilità dei punteggi osservata rende necessarie ulteriori verifiche prima di un’applicazione su larga scala.
Gli stessi autori sottolineano la necessità di migliorare accuratezza e consistenza dei modelli e indicano tra le prospettive future il confronto tra sistemi closed-source e open-source, questi ultimi potenzialmente più adattabili a contesti clinici specifici attraverso personalizzazione e fine-tuning.
Il dato centrale resta quindi duplice: le trascrizioni possono ridurre notevolmente il carico di lavoro dei docenti mantenendo una buona corrispondenza con la valutazione video, mentre l’AI mostra potenzialità interessanti ma non ancora una stabilità sufficiente per sostituire in modo affidabile la valutazione umana.